RAG 的第一道坎,可能不是大模型,而是 PDF
知识库效果好不好,很大程度上取决于文档有没有被正确解析。复杂 PDF 如果在入口处就把表格、公式和阅读顺序弄错,后面的检索和生成再强也很难补回来。
PDF 转 Markdown 是一个绕不开的需求。训练大模型需要干净的文本语料,做知识库和 RAG 要把 PDF 拆成结构化内容,写论文笔记、整理资料也经常需要提取 PDF 里的表格和公式。
PDF 本身是为看而设计的格式,不是为读而设计的。怎么把它转成机器和人都好用的 Markdown,一直是个需求明确、但解决得不够好的问题。
主流开源方案我基本试了一轮,能把双栏论文、跨页表格、公式密集的文档稳定搞定的并不多。实测下来,MinerU2.5 是目前综合体验最好的开源方案之一——识别质量、速度、部署成本三者兼顾,而且完全开源。
此前我写过一篇 MinerU Pipeline 的拆解,介绍了它如何用 Layout Detection → OCR → Formula/Table Recognition → 后处理规则,一步步把 PDF 转成 Markdown。这套方案的问题很直观:多个专业模型串成一条链,Layout 判错一个框,后面全跟着错位;每个模型都要单独部署和维护,后处理规则也越堆越多。
同一团队随后发布的 MinerU2.5 换了一种思路:不用多个专业模型接力,只用一个 1.2B 参数的 VLM,让它跑两遍。
两遍的分工很清楚:
🔭 第一遍,看全局:缩略图扫一眼整页,搞清楚这里有什么、在哪、什么方向、按什么顺序读。
🔬 第二遍,看细节:拿着第一遍标好的位置,去原图裁对应区域放大看,识别出具体内容。
同一个模型,切换 Prompt 就能完成不同的任务。整条流水线的结构:
📄 缩略图 → 🔭 版面分析 → ✂️ 裁剪 + 校正 → 🔬 内容识别 → 📝 Markdown
🔭 第一遍:版面分析——搞清楚有什么、在哪
这一步要回答的问题是:这页文档有什么、在哪、什么方向、什么顺序。
为什么先看缩略图,不看原图
直接在高分辨率原图上做版面分析,有两个绕不开的问题。一是 VLM 的 visual token 数量随像素平方增长,一页 A4 级别的文档动辄产生数千 tokens,页面里大片的空白边缘和行间距都在白白消耗算力。二是版面分析本身不需要看清每个字的笔画——只需要知道“这里有一块表”“那里有一段正文”,缩略图完全够用。
MinerU2.5 把整页降采样到 1036×1036 像素。这个尺寸是权衡过的:太小会丢失细粒度元素的边界(比如小号字体、紧密排列的图注),太大又会落入 VLM 编码器的平方复杂度区间,得不偿失。用固定尺寸而不是保持原始宽高比,是因为固定尺寸下 bbox 的定位更稳定。
一次推理,四样东西一起出
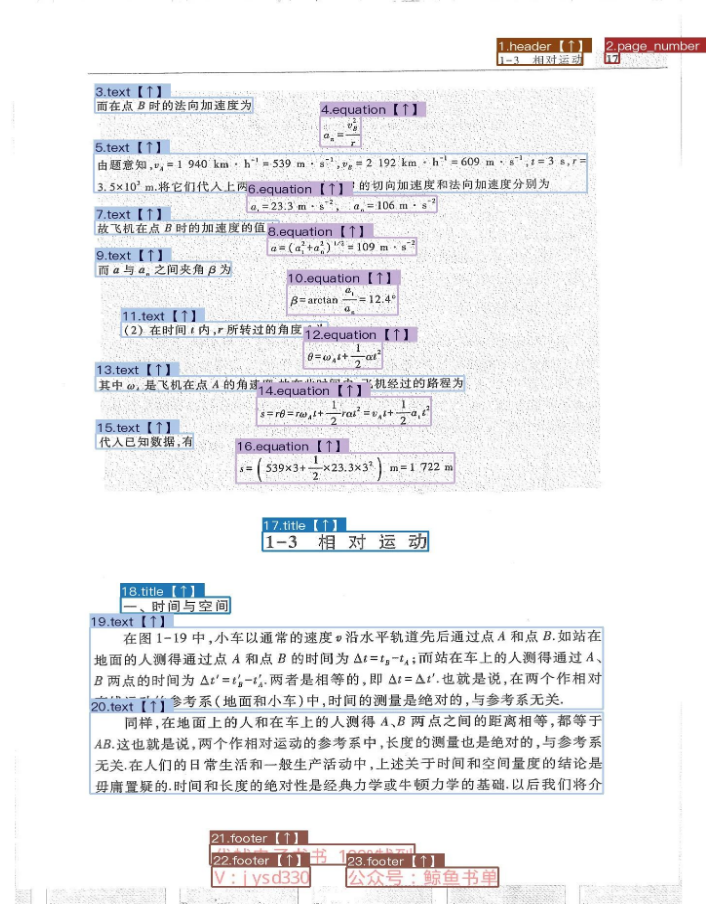
模型用 Prompt Layout Detection: 看这张缩略图,输出页面上每个元素的结构化信息:
1
2
3
4
Box: [163  81 836 129]   Type: Table Caption   Orientation: up   Order: 1
Box: [169 138 831 250]   Type: Table           Orientation: up   Order: 2
Box: [162 264 486 471]   Type: Text            Orientation: up   Order: 3
...
跟 Pipeline 的 Layout Detection 一对比,差异很清楚:
- Pipeline:只输出 label + bbox → 阅读顺序靠后处理几何规则推断 → 旋转文本需单独判定方向后再校正
- MinerU2.5:一次输出 label + bbox + 方向 + 顺序 → 下游直接使用,无需再猜
类别也从 Pipeline 的十几种扩展到了 20 多种——除了基础的 text、title、table、formula、image,还细分出了 code、algorithm、list、reference、header、footer、pagenumber、aside text 等。
交给下一步
第一遍产出的是一份 bbox 列表。程序对每个 bbox 做三件事:
- 从原始高清图(不是缩略图)按坐标裁出对应区域;
- 如果旋转方向不是 up,直接旋转校正;
- 根据类别,决定接下来用哪个 Prompt。
💡 关键设计:高清像素只在裁剪后的局部区域进入推理,整页高清从头到尾不进入 VLM——token 爆炸从根源上被规避。旋转校正也顺带完成,Pipeline 中“先判方向、再校正、再识别”的串行开销不复存在。
🔬 第二遍:内容识别——搞清楚具体是什么
第一遍告诉你这里是什么,第二遍负责把内容真正识别出来。
同一个 MinerU2.5,根据类别切换不同 Prompt:文字用 Text Recognition:,公式用 Formula Recognition:,表格用 Table Recognition:。输入都是从原始高清图里裁出来的局部区域。
📄 文本:最直接的识别路径
Prompt 用 Text Recognition:,输入是裁剪出的文字区域图片(原生分辨率),模型直接输出纯文本:
1
2
The results of the analyses of the uncertainty of the field data
and related assumptions are shown in Figs 13 and 14.
没有坐标、没有标签,输出即所得。这一点跟 Pipeline 不同——Pipeline 的文字来源要分两条路:扫描件跑 OCR 模型,数字 PDF 直接读文本层。MinerU2.5 统一走 VLM 识别,无论原文件是扫描件还是数字 PDF。
🧮 公式:复杂的先拆开再识别
短公式可以直接识别成 LaTeX。遇到长公式或多行推导,MinerU2.5 会先把它拆成几个更简单的公式片段,分别识别,再按原来的位置关系拼回去。
论文把这套方法叫做 ADR(Atomic Decomposition and Recomposition)。
🧮 复杂公式 → ✂️ 拆开 → 🔍 分别识别 → 🧩 重新组合
核心思路就一句话:一个复杂任务不好做,就先拆成几个简单任务。
📊 表格:先识别结构,再转成 HTML
表格也没有直接让模型生成一长串 HTML,而是先输出一种更简洁的表格结构表示——OTSL,再通过规则转换成标准 HTML。
📊 表格 → 🔍 识别结构 → 🧱 OTSL → 🔄 HTML
这样模型只负责看懂表格,而格式转换交给确定性的规则处理。对于大表格和复杂合并单元格,这种方式也更稳定。
换句话说,公式和表格虽然各自有一点特殊处理,但都没有改变第二阶段的核心:只对第一阶段找出来的局部高清区域做精细识别。
📐 与 Pipeline 的对比
| 环节 | MinerU Pipeline | MinerU2.5 |
|---|---|---|
| Layout | 专用检测模型(label + bbox) | VLM 看缩略图(label + bbox + 方向 + 顺序) |
| 文字 | OCR 模型 / 直接读取 PDF 文本层(两套路径) | VLM 第二遍统一识别 |
| 公式 | 专用公式模型 → LaTeX | 第二遍 + ADR 拆-合 |
| 表格 | 专用表格模型 → HTML | 第二遍 → 表格中间表示 → HTML |
| 阅读顺序 | 后处理靠几何规则推断 | 第一遍直接给编号 |
| 后处理 | 大量几何规则(框归属、段落合并等) | 极简,核心只剩表格格式转换 |
💡 Pipeline 的复杂性散落在一堆专业模型和海量规则里;MinerU2.5 把它们收回到一个 VLM 中,靠两次推理的分工和 Prompt 切换组织起整条流水线。
知识库和 RAG 的上限,很多时候就是被 PDF 解析这一层卡住的。如果你正在被表格错位、公式乱码折磨,建议直接拿自己的文档去跑一遍——这种事听别人说没用,十分钟就能验证。
你目前在用什么方案解析 PDF?欢迎在评论区聊聊踩过的坑。
📄 论文:MinerU2.5: A Decoupled Vision-Language Model for Efficient High-Resolution Document Parsing