拆解 MinerU:一个开源 PDF 解析工具,如何把花样百出的 PDF 变成干净的 Markdown?
从论文 PDF 到考研试卷,各种格式的文档都能认出标题、正文、公式、表格……MinerU 是怎么做到的?本文拆解它的四阶段流水线,讲清模型与规则如何分工协作。
如果你做过 RAG,或者试过把 PDF 喂给大模型,大概率遇到过这些翻车现场:
🔥 论文里的公式变成了乱码
🔥 表格被拆成一行一行的碎片文字
🔥 双栏排版的文章,读到一半突然跳到右边那栏
🔥 扫描版 PDF 和电子版 PDF,得用完全不同的方式处理
这些问题的根源只有一个——
🎯 PDF 是为“看起来一样”而生的,不是为“读起来对”而生的。
上海人工智能实验室开源的 MinerU,正是为了解决这个难题。它能把各种花样的 PDF——论文、教科书、财报、试卷、PPT、历史文献——统统变成干净的 Markdown 或结构化 JSON。
📢 提示:MinerU 支持多种解析后端(pipeline、hybrid、vlm)。本文拆解的是最基础、最核心的 pipeline 后端,其余暂不涉及。
它是怎么做到的?下面拆开它的四阶段管线,把核心思路讲清楚。
一、📐 一张图看清全局
MinerU 的处理流程从上到下分成四个阶段,每个阶段的产出就是下一阶段的输入,数据像流水线一样从头流到尾:
| 阶段 | 核心任务 | 关键词 |
|---|---|---|
| 预处理 | 把 PDF 变成模型能“看”的东西 | 渲染图片、判定扫描/数字 |
| 内容解析 | 用模型检测和识别所有内容 | Layout 总指挥 + 四个专业模型 |
| 后处理 | 把孤立的框变成有结构的内容 | 框归属、段落合并、阅读顺序 |
| 格式转换 | 渲染为最终输出 | Markdown / JSON |
整个管线内部还有一个“中间格式”(middle JSON),作为各阶段之间的约定——这个设计在后面会展开聊。
二、🎨 预处理:把 PDF 变成模型能“看”的东西
这个阶段的逻辑很直白:所有后续模型都是视觉模型,需要像素输入。 所以第一步就是把 PDF 的每一页渲染成图片。
但渲染之前要先做一件事——判断这个 PDF 是“扫描件”还是“数字 PDF”:
| 类型 | 特征 | 后续文字来源 |
|---|---|---|
| 扫描件 | 本质是图片,文字“画”在上面 | 需要 OCR 识别 |
| 数字 PDF | 有文字层,可以选中和复制 | 直接从 PDF 文本层读取 |
这个判定很关键——它决定了后面文字是从 OCR 来,还是从 PDF 文本层直接提取。两条路径在后面的阶段会走不同的路。
💡 统一渲染成图片还有一个隐藏好处:不同 PDF 生成器写出来的文本层格式天差地别,统一用图片做输入,直接绕开了这些格式差异。
三、🧠 内容解析:Layout 做“总指挥”,五个模型各司其职
这是整个管线里最“重”的阶段——调用了五个 ML 模型,但分工很清晰。
3.1 核心思路
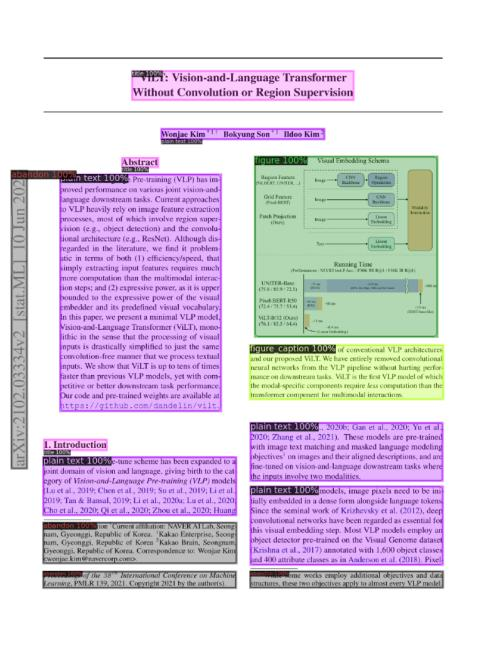
Layout Detection 先跑,画出一页的布局图谱——哪里是标题、哪里是正文、哪里是表格、哪里是公式、哪里是图片。然后各专业模型按图谱各司其职:
| 模型 | 做什么 | 输入 | 输出 |
|---|---|---|---|
| Layout Detection | 检测所有区域类型和位置 | 整页图片 | label + bbox + 阅读顺序 |
| Formula Recognition | 识别公式内容 | 公式区域裁剪图 | LaTeX 字符串 |
| Table Recognition | 识别表格结构和内容 | 表格区域裁剪图 | HTML table |
| Text OCR | 识别文字 | 文字区域裁剪图 | 文字 + 坐标 |
| Seal OCR | 识别印章 | 印章区域裁剪图 | 印章文字 |
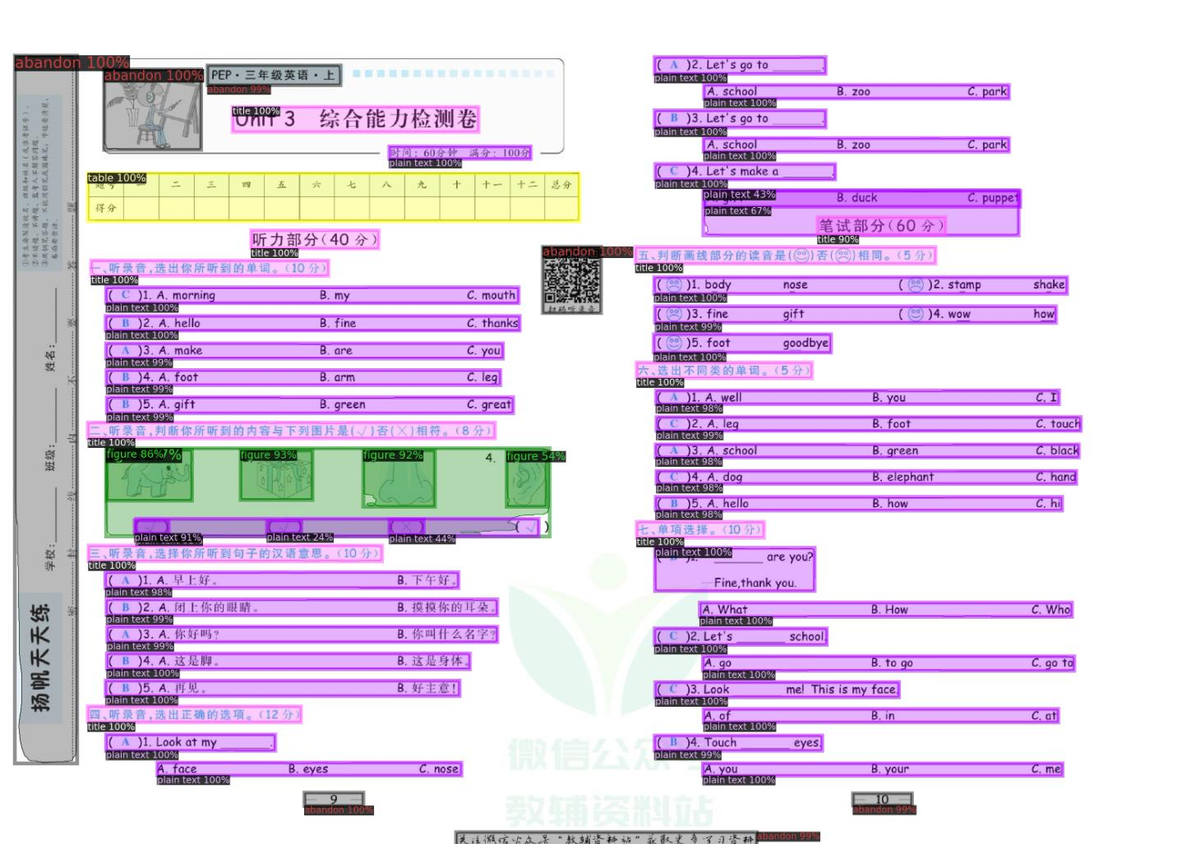
📊 Layout Detection 的实际效果:一页论文被切分成 title、text、table、formula、image 等区域,每个区域的类型、位置和阅读顺序都被精确标注。
3.2 为什么 Layout Detection 必须先跑?
如果不用 Layout Detection,直接把整页丢给 OCR,会发生什么?看看论文里的对比:
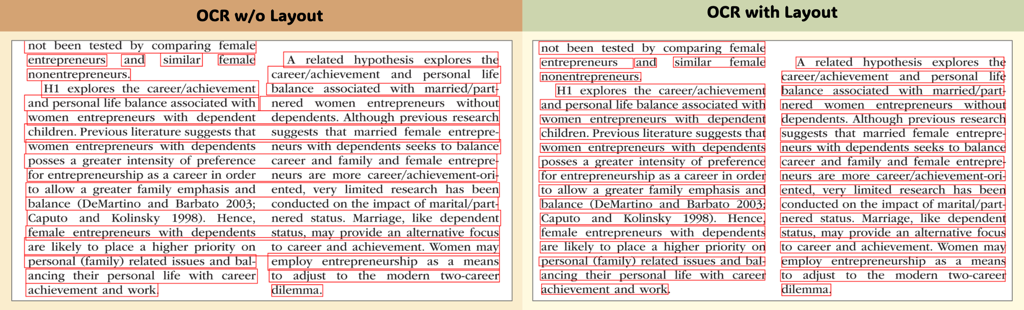
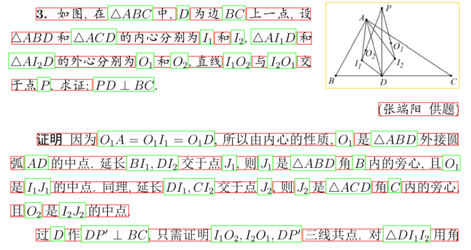
👈 左:没有 Layout Detection,多栏文档的文字顺序完全乱了。 👉 右:加了 Layout Detection,先检测出每一栏的边界,再在栏内逐行 OCR,顺序就对了。
这个对比说明了一个简单的道理:OCR 只管“认出文字”,不管“文字之间的先后关系”——后者是 Layout Detection 和后处理阶段要解决的问题。
3.3 公式处理的巧思
MinerU 把公式分成两类处理:
- 行间公式(独占一行的公式块):Layout Detection 直接检测出来,交给公式识别模型转为 LaTeX。
- 行内公式(嵌在文字里的公式,如 $x^2+y^2=z^2$):Layout Detection 之后,还有一个专门的公式检测模型(YOLOv8 fine-tune),负责在文字区域里把行内公式抠出来。
为什么要单独一个模型?因为 100cm²、(α₁,α₂,...,αₙ) 这类符号,Layout Detection 很难跟普通文字区分开。一旦漏检,直接丢给 OCR(或从 PDF 文本层硬读),公式符号大概率变成乱码。更稳的做法是:先把它检测出来、掩码掉,等文字提取跑完,再把 LaTeX 结果回填进去。
行内公式检测对扫描件和数字 PDF 同样必要。数字 PDF 虽然文字层自带坐标,但公式符号在里面常常是乱码或直接缺失——不同 PDF 生成器对数学符号的编码五花八门,谁也说不准会遇到哪种写法。所以不管文字从哪来,行内公式都得靠专门的检测 + 识别模型来兜底。
3.4 扫描件 vs 数字 PDF:分化点
到这里,两种 PDF 的路线开始分化。注意:Layout Detection、Formula Detection/Recognition、Table Recognition 完全相同——不管什么 PDF,公式和表格都得靠模型来认。差异只在于正文文字怎么来:
| 扫描件 | 数字 PDF | |
|---|---|---|
| Layout / Formula / Table | 与数字 PDF 完全相同 | 与扫描件完全相同 |
| Text OCR | 全页面文字检测+识别 | 只对表格内文字、印章等特殊情况 |
| 阶段产出 | layout_dets 里带 ocr_text | layout_dets 只有区域框,没有正文文字 |
数字 PDF 的正文文字留到后处理阶段从 PDF 文本层直接读。
举个具体例子。一页内容包含标题、正文(嵌了一个行内公式 $E=mc^2$)、表格。两种 PDF 经过 Content Parsing 后的 layout_dets 分别长这样:
扫描件——正文由 OCR 逐段识别,文字直接挂在结果里:
1
2
3
4
5
6
7
8
9
10
[
  {"index": 1, "bbox": [100,50,400,80],   "label": "title"},
  {"index": 2, "bbox": [100,100,400,210],  "label": "text"},
  {"index": 3, "bbox": [100,230,400,370],  "label": "table",  "html": "<table>…</table>"},
  {"bbox": [200,130,240,150],   "label": "ocr_text",         "text": "这是正文,其中"},
  {"bbox": [245,130,290,150],   "label": "ocr_text",         "text": "E=mc"},
  {"bbox": [295,130,320,150],   "label": "ocr_text",         "text": "2"},
  {"bbox": [325,130,400,150],   "label": "ocr_text",         "text": " 是一个著名公式"},
  {"bbox": [245,128,320,152],   "label": "inline_formula",   "latex": "E=mc^2"}
]
数字 PDF——正文不在这里,只有区域框和公式:
1
2
3
4
5
6
[
  {"index": 1, "bbox": [100,50,400,80],   "label": "title"},
  {"index": 2, "bbox": [100,100,400,210],  "label": "text"},
  {"index": 3, "bbox": [100,230,400,370],  "label": "table",  "html": "<table>…</table>"},
  {"bbox": [245,128,320,152],   "label": "inline_formula",   "latex": "E=mc^2"}
]
两种一对比就很清楚:扫描件里那一堆
ocr_text是 OCR 逐段吐出来的正文;数字 PDF 里正文完全不在——等后处理阶段从文本层提取。但行内公式inline_formula两边都在,因为公式符号从文字层读出来大概率是乱的,必须靠模型来认。
四、🔧 后处理:把孤立的框变成有结构的内容
这是整个管线里最体现“工程味”的阶段。上一步模型输出的是一堆孤立的 label + bbox——“这块是标题”、“那块是正文”、“这个框是表格”——但块与块之间的关系?完全不知道。
后处理分两步:先逐页结构化,再跨页整理。
4.1 逐页结构化:MagicModel
核心任务是把文字 span 按 bbox 重叠关系匹配到对应 block,然后把零散的 span 聚合成行、行聚合成段落。有几个关键操作:
1. Visual Block 的归属分类
模型输出的原始标签是孤立的:
1
2
3
4
5
6
[image]      ← 这是一张图
[caption]    ← 这是图注还是表注?不知道
[text]       ← 这是正文还是脚注?不知道
[table]      ← 这是一张表
[caption]
[footnote]
MagicModel 基于空间位置和阅读顺序,把 caption 和 footnote 归属到正确的 image/table/chart block 下。 找不到归属的 caption 会被降级为普通 text,避免错乱。
2. 过滤与清洗
header、footer、页码、边栏——这些对理解内容没有帮助的东西,会在 MagicModel 阶段被识别出来,直接丢弃。
3. 两条路径的汇合点
这是整个管线设计的精髓:不管扫描件还是数字 PDF,到了 MagicModel 这一步,处理逻辑完全一致。 唯一的区别只在入口。扫描件的文字,从 Content Parsing 阶段的 OCR 结果里直接取;数字 PDF 则要等到这一步,才通过 txt_spans_extract 从文本层提取(字符自带坐标)。
为什么数字 PDF 不早点提取文字?因为 Layout Detection 需要先知道每一页有哪些区域,才能给文字提取划定范围。与其提前“盲读”,不如等 Layout 图谱画好了按图索骥。
4.2 跨页文档级处理
逐页搞完之后,以整篇文档的视角再做一遍梳理:
| 步骤 | 做什么 | 有意思的地方 |
|---|---|---|
| 段落拆分合并 | 把相邻的同类 block 合并,跨页段落也接上 | 纯几何启发式——看对齐、缩进、空格模式 |
| 列表/目录识别 | 区分普通段落和列表 | 靠几何特征:数字前缀、行尾模式、悬挂缩进 |
| 跨页表格合并 | 拼接被分到两页的大表格 | 用表格结构特征判断是不是同一张表 |
| 标题层级整理 | 大标题、小标题的层级关系 | 基于字体大小、位置和序号规则 |
| 公式编号配对 | 如 “E=mc² (1)” 中公式和编号的关联 | 基于 bbox 距离和编号格式 |
💡 段落拆分和列表识别完全不用 NLP,纯粹是几何启发式规则——靠行间距、缩进差、对齐方式这些视觉特征,不看语义。方法简单,但在排版规范的文档上表现很好。
输入: Content Parsing 产出的 layout_dets 输出: middle_json——MinerU 内部的“中间约定”,三个核心字段:
1
2
3
4
middle_json
├─ preproc_blocks    ← MagicModel 处理后的结构化 block 列表
├─ discarded_blocks  ← 被丢弃的 header/footer/页码
└─ para_blocks       ← 段落合并和列表识别后的最终结构
五、📝 格式转换:中间的 JSON,变成最终的 Markdown
最后一步是按 block 类型逐个分发、渲染:
| Block 类型 | 渲染方式 |
|---|---|
| title | # × level(如 ## 二级标题) |
| text / abstract | 段落文本,CJK 不加空格,单词间加空格 |
| inline_equation | $latex$ |
| interline_equation | $$latex$$,没识别出 LaTeX 就降级为图片 |
| image / chart |  |
| table | 直接嵌入 HTML(Markdown 表格能力有限) |
| code | ` lang `,自动检测编程语言 |
| list / index | 按列表项换行分隔 |
MinerU 支持四种输出模式:
| 模式 | 说明 |
|---|---|
| MM_MD | 多模态 Markdown,保留图片、表格等全部内容 |
| NLP_MD | 纯文本 Markdown,去掉图片和表格 |
| Content List v1/v2 | 结构化 JSON,v2 类型划分更细 |
来看论文里的实际效果:
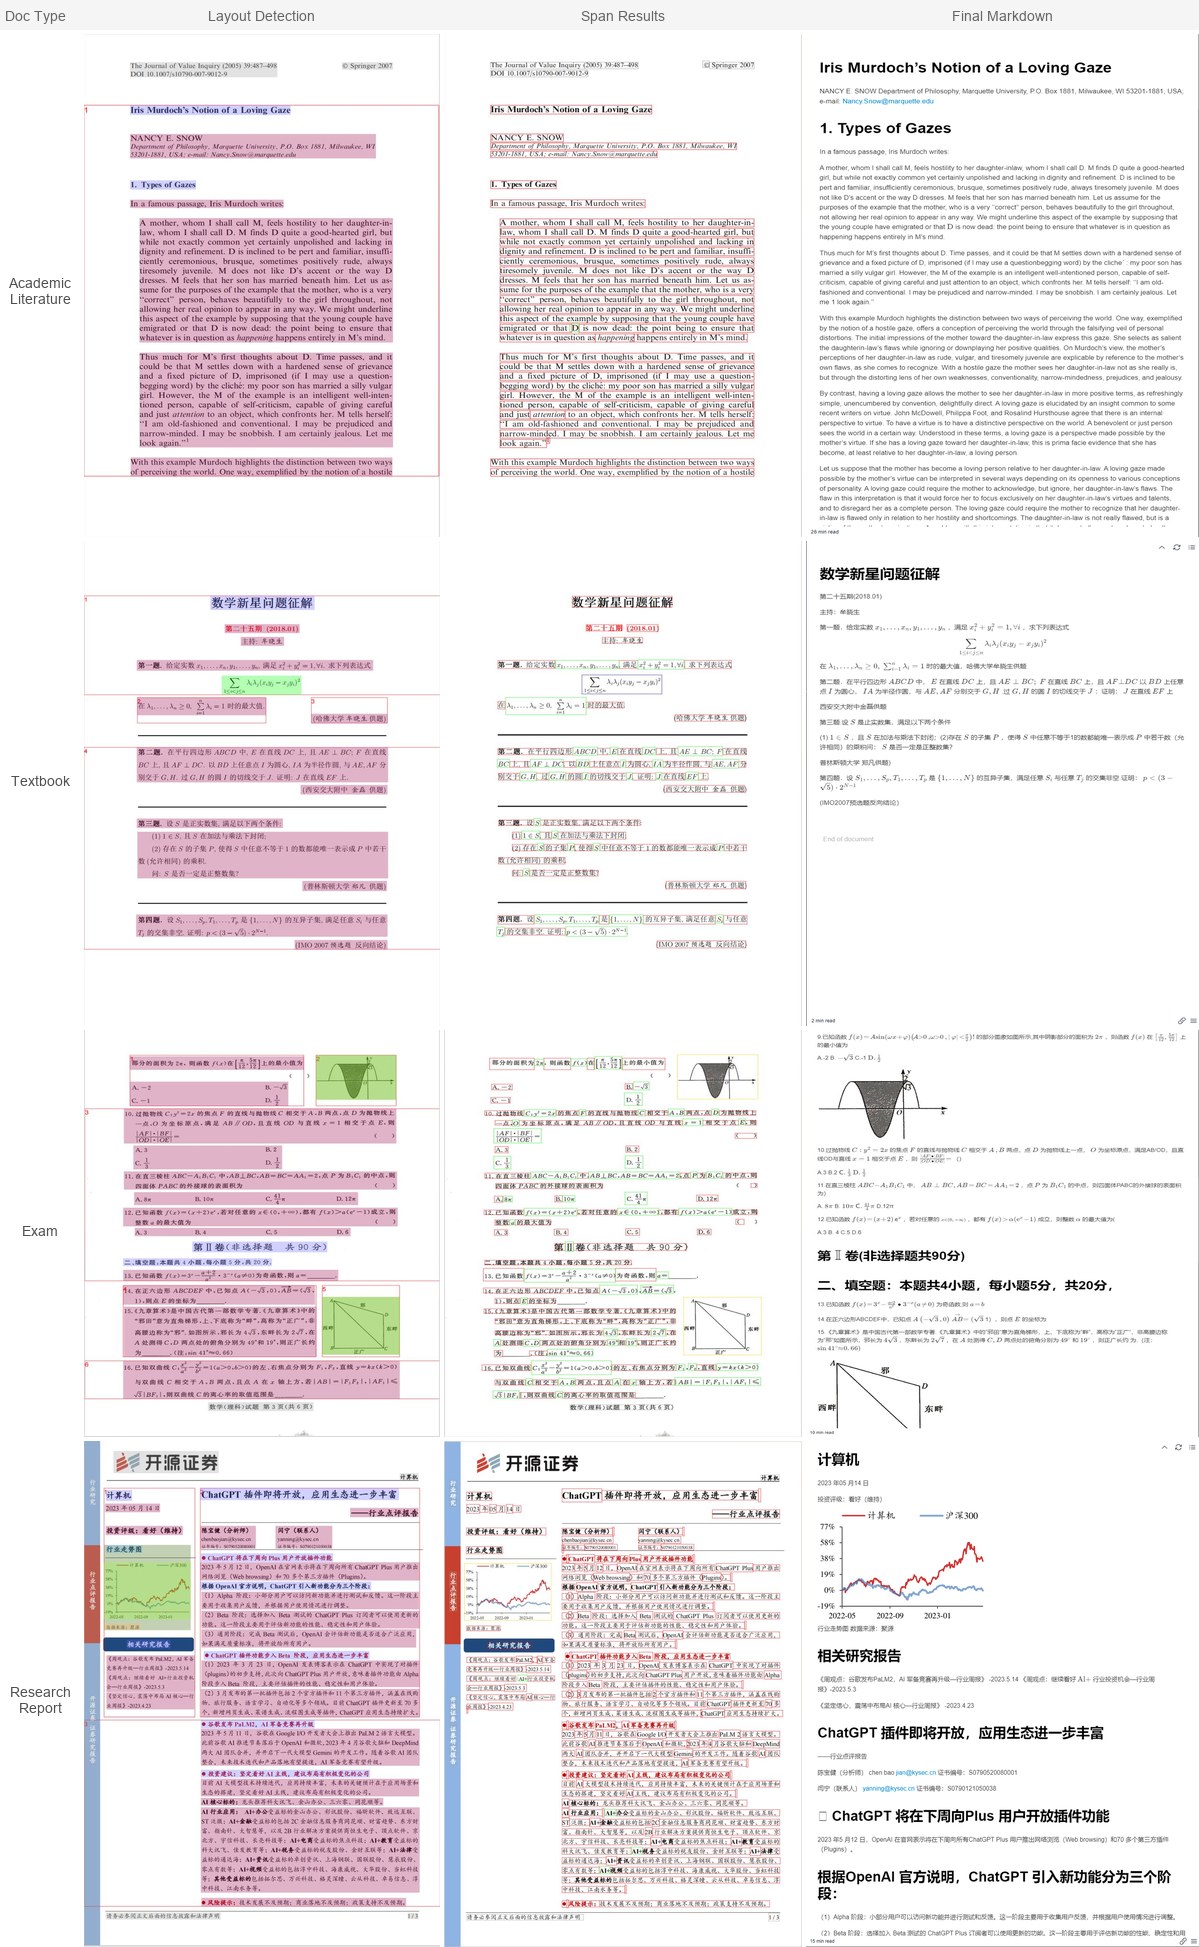
📊 四行对应四种文档类型(学术论文、教科书、试卷、研究报告),三列分别是 Layout Detection 检测结果 → span 识别结果 → 最终 Markdown。不同类型的文档在每一步都得到了准确定位和提取。
六、✨ 总结
MinerU 做对了几件事:
✅ 四阶段分层设计 —— 每层解决一个层次的问题,产出明确、边界清晰。
✅ 模型 + 规则的混合策略 —— 模型做它擅长的“检测”,规则做它擅长的“理解”,各取所长。
✅ 扫描件和数字 PDF 的分合处理 —— 两条路径,一条主线,汇合后完全统一。
✅ 多样本数据驱动的模型训练 —— Layout Detection 在教科书等复杂文档上远超通用模型,靠的是多样性数据的迭代训练。
当然,MinerU 也有局限性:目前主要支持中英文,其他语言效果不保证;遇到复杂手写、极端排版,质量也会打折扣。
但这些局限不影响它代表的工程思路——
🎯 用专业模型处理各自擅长的问题,用规则把结果缝合起来。
🎯 不要指望一个“通吃”的模型解决一切。
对于做 RAG 或文档处理的同学来说,理解 MinerU 的管线设计,比自己从头踩一遍坑划算得多。
参考:
- MinerU 论文:MinerU: An Open-Source Solution for Precise Document Content Extraction
- 源码分析:基于 MinerU 源码仓库的 pipeline 模块逐层拆解