Anthropic 的 Agent 构建经验:能简单,就别复杂
什么时候用工作流,什么时候需要自主 Agent?结合 Anthropic 的 5 种工作流与 6 张架构图,理解如何从简单方案出发,按需增加复杂度。
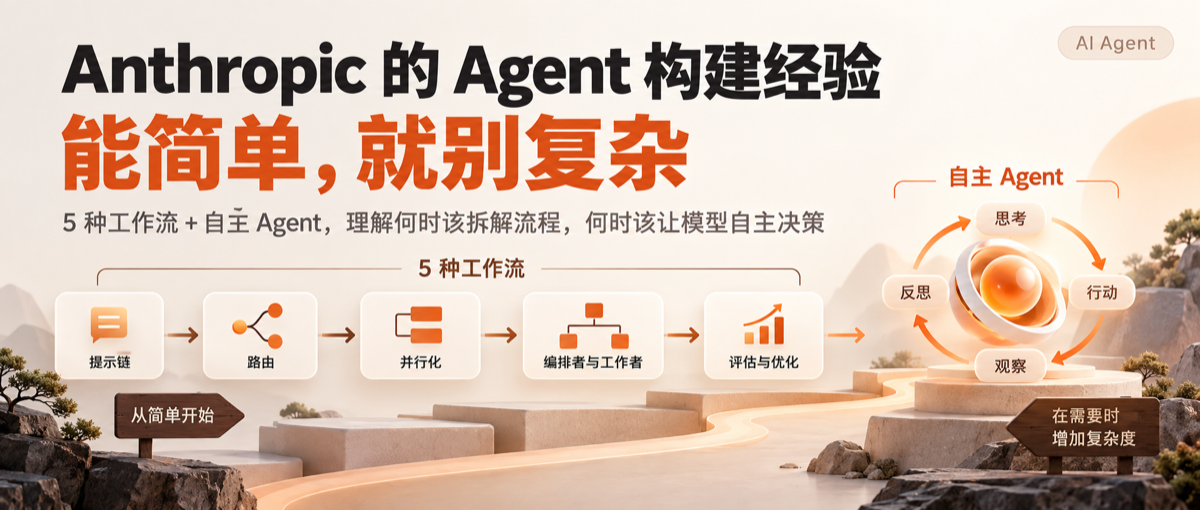
做 AI 应用时,一次模型调用能解决的任务,有必要搭成 Agent 吗?多加几个工具、几轮反思,效果就会更好吗?Anthropic 给出的建议很明确:从最简单的可行方案开始,只有在确实改善结果时,才增加复杂度。
在《Building effective agents》中,Anthropic 分享了与不同行业数十个团队合作的经验:成功的实现往往采用简单、可组合的模式。
下面结合原文的 6 张架构图,看看 5 种工作流各自解决什么问题,以及什么时候才需要让模型自主决定下一步。
🧩 工作流与 Agent:谁来决定下一步?
“Agent”没有完全统一的定义。有些人用它指能够独立运行、调用工具完成复杂任务的自主系统;也有人把按预设流程执行的系统叫作 Agent。
Anthropic 将这些实现统称为 Agentic Systems(智能体系统),但在架构上区分了两类:
- 工作流(Workflow):代码预先规定执行路径,组织模型与工具完成任务。
- 自主 Agent:模型根据任务和反馈,动态决定执行步骤与工具使用方式。
两者的关键区别在于:谁来决定下一步做什么?
比如写文章,如果程序规定先列大纲、再写正文,这就是工作流。
如果模型根据目标,自行判断是否需要查资料、补充采访问题、修改结构,再决定下一步,这就更接近自主 Agent。
调用了多少次模型、接入了多少个工具,并不能单独决定它属于哪一类。
🧭 选择架构:从最简单的可行方案开始
对不少应用来说,把单次模型调用做好,配合检索和示例,就已经够用。引入多步执行和自主决策,通常会增加延迟与成本,效果是否更好,还需要验证。
选择架构时,可以按这个顺序判断:
- 一次调用能完成吗? 先优化提示词(Prompt)、检索内容和上下文示例。
- 不能一次完成,但步骤基本确定吗? 用工作流拆解和组织任务。
- 连步骤都需要边做边判断吗? 再考虑给 Agent 更多自主性。
任务定义清晰时,工作流更容易保持可预测性和一致性;执行过程需要持续调整时,自主 Agent 才更有发挥空间。
🛠️ 5 种工作流,分别解决什么问题?
下面五种模式,分别解决顺序执行、分类处理、并行处理、动态分工和迭代优化的问题。它们可以单独使用,也可以组合。
以下六张架构图来自 Anthropic 原文。图中的 LLM Call 指一次大模型调用,In 和 Out 分别表示输入与输出。
1️⃣ 提示链:把固定步骤串起来
Prompt Chaining · 固定步骤,依次完成。
提示链把一个任务拆成一系列连续步骤,每次模型调用处理上一步的输出。中间还可以加入程序化检查,确认上一步的结果符合要求,再继续执行。
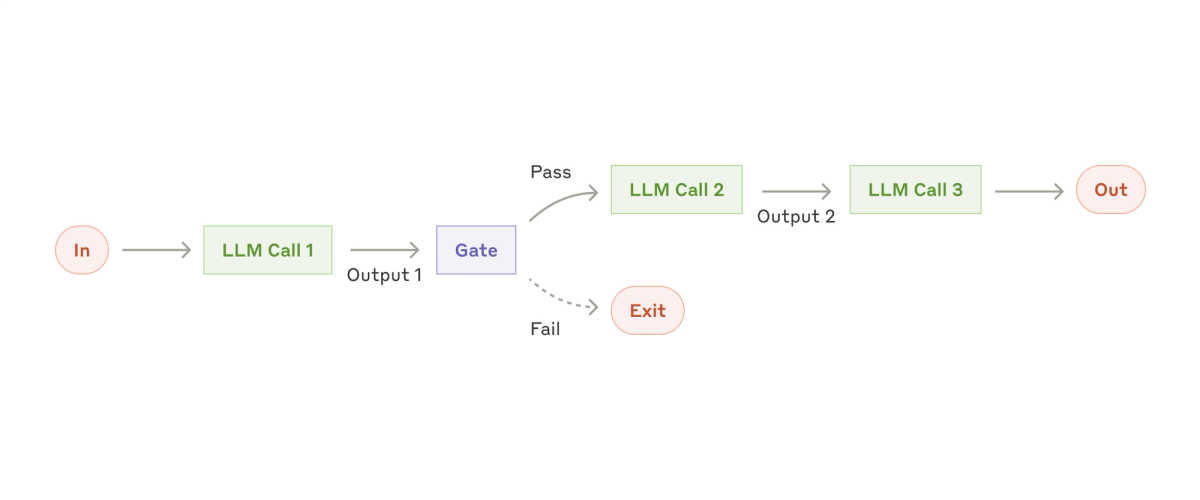
图 1|提示链。Gate 为检查点,通过后继续,未通过则退出。
每次调用只处理一个更简单的任务,有机会提高准确性,代价是逐步执行带来的等待时间。
比如写文章,可以按“生成大纲 → 检查大纲 → 撰写正文”的顺序执行。大纲不符合要求时,先拦下来,避免问题一路传到正文。
2️⃣ 路由:让不同问题进入对应流程
Routing · 先分清类别,再交给对应流程。
路由先对输入进行分类,再交给相应的专门流程处理。
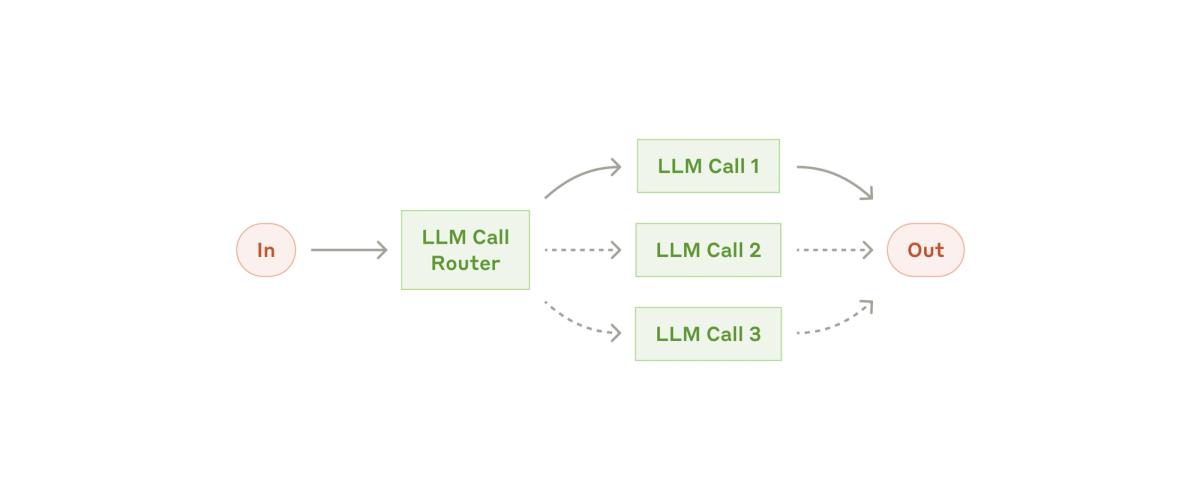
图 2|路由。Router 根据输入选择处理分支。
这样可以为不同问题设计更有针对性的提示词和工具,减少不同任务之间的相互干扰。
前提是输入能够被准确分类。这一步可以交给大模型,也可以使用传统分类模型或规则。
比如,客服收到一般咨询、退款请求和技术问题后,分别进入对应的处理流程。
也可以将简单、常见的问题交给成本较低的小模型,将困难的问题交给能力更强的模型,在效果和成本之间做权衡。
3️⃣ 并行化:同时处理,再汇总结果
Parallelization · 独立任务同时做,多次判断再汇总。
有些任务可以让多个模型调用同时执行,再用程序汇总结果。
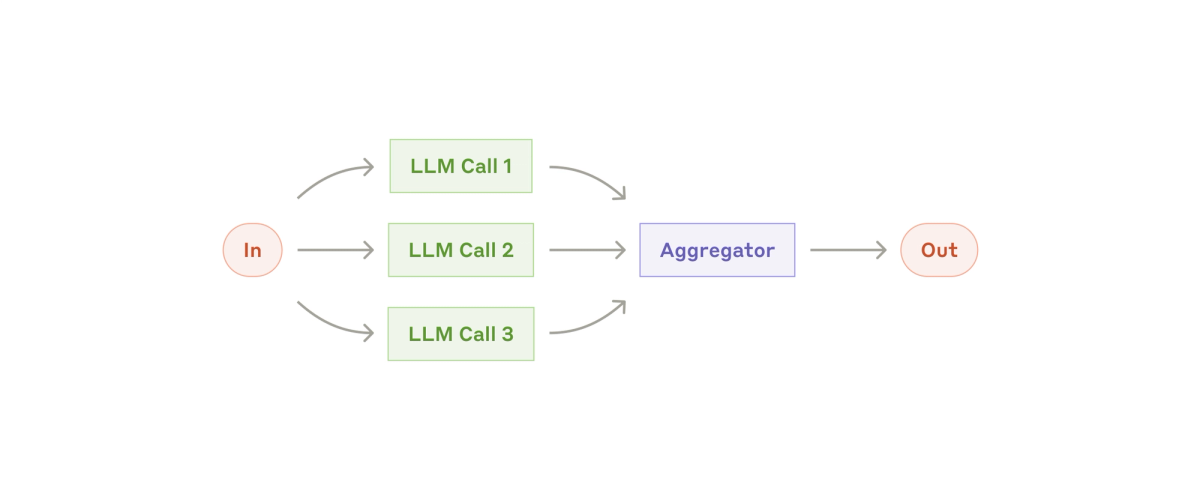
图 3|并行化。Aggregator 负责汇总多个调用的结果。
并行化主要有两种形式:
- 任务拆分(Sectioning):分别处理独立的子任务。比如评估一段回答时,同时检查事实是否准确、表达是否清晰、是否遵循用户要求。
- 投票(Voting):对同一任务执行多次,再综合判断。比如用不同提示词审查同一段代码,汇总发现的漏洞。
前者让处理更专注,也可能缩短等待时间;后者提供更多判断依据。需要注意,多次调用会增加成本,多数意见也不一定正确。
4️⃣ 编排者与工作者:按任务动态分工
Orchestrator-Workers · 根据当前任务,动态拆解和分工。
在这种工作流里,一个大模型担任编排者,动态拆解任务,将子任务分配给其他模型,再汇总结果。
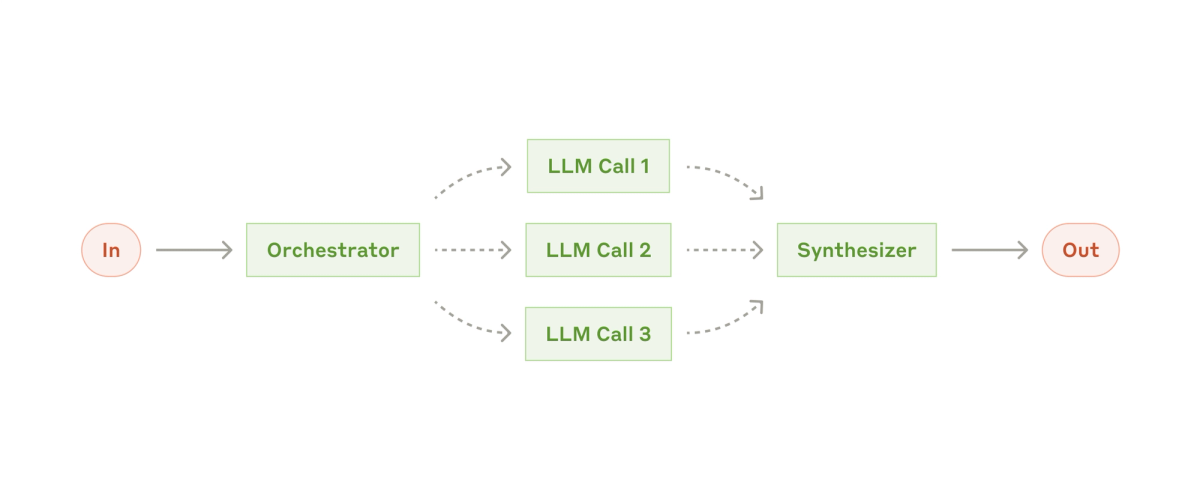
图 4|编排者与工作者。Orchestrator 分配任务,Synthesizer 整合结果。
比如修改代码,需要动几个文件、每个文件具体怎么改,往往取决于这一次的任务,无法提前写死。
它在结构上看起来和并行化相似,但有一个关键区别:并行化的子任务通常是预先确定的;编排者与工作者模式中的子任务,则由编排者根据当前输入动态决定。
它仍可归为工作流,是因为模型决定的是局部的任务分工,外层仍遵循“拆解 → 分配 → 汇总”的既定结构。动态分工,并不等于整个执行过程都由模型自主决定。
5️⃣ 评估与优化:根据反馈反复改进
Evaluator-Optimizer · 先生成,再评价,根据反馈继续改。
这种工作流中,一个模型调用负责生成结果,另一个负责评价并提出反馈,再由生成方根据反馈修改,形成迭代循环。
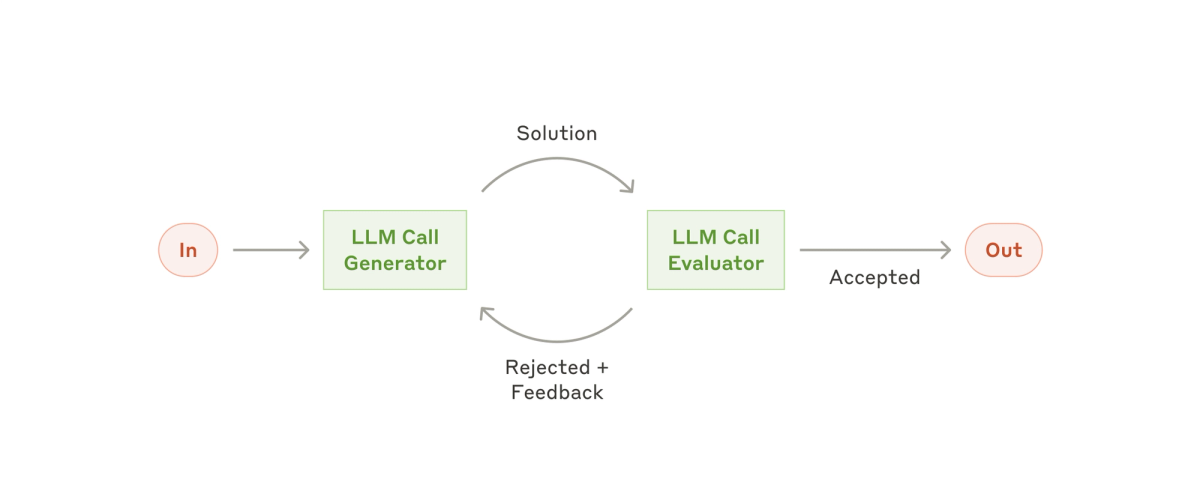
图 5|评估与优化。Generator 生成方案,Evaluator 决定接受或返回反馈。
可以用两个信号判断是否适合:
- 人类给出明确反馈后,模型的回答能够明显变好。
- 模型本身也有能力提供这样的反馈。
这很像写作时的修改过程:先有初稿,再根据具体意见打磨。比如文学翻译,翻译模型可能遗漏了细微含义,评估模型指出问题后,再进行针对性修改。
落地时,还需要约定什么算“达标”,以及最多修改几轮。否则,评价与修改很容易变成没有明确终点的循环。
🤖 什么时候需要自主 Agent?
如果需要根据每一步的结果,持续决定接下来做什么,就可以考虑自主 Agent。它需要理解任务、规划行动、使用工具,并在出错后调整方向。
Agent 的任务可以始于用户的一条指令,也可以通过对话逐步明确。任务明确后,Agent 自主规划并执行,必要时再请用户补充信息或做出判断。
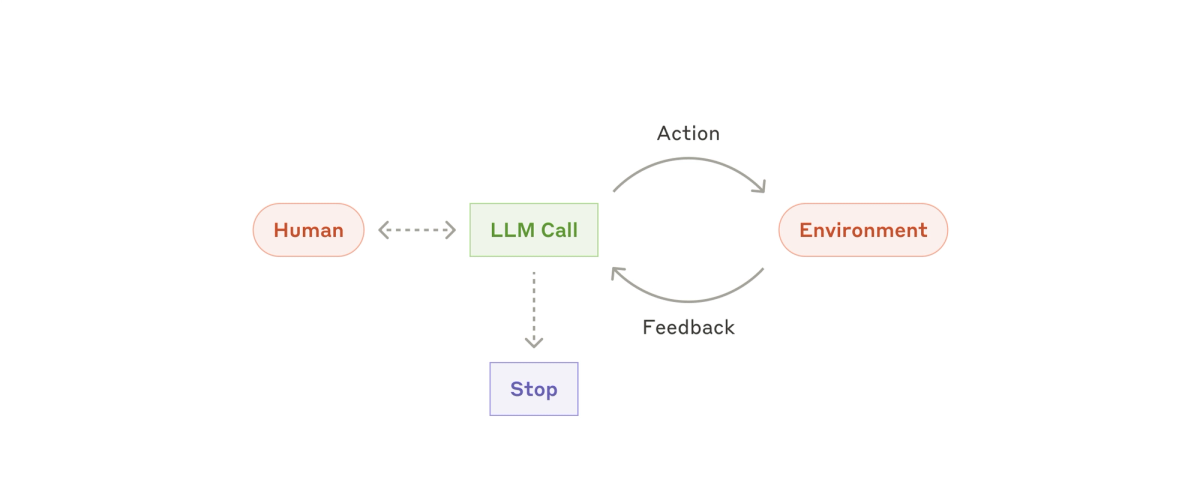
图 6|自主 Agent。Action(行动)与 Feedback(反馈)构成循环,必要时与人交互或停止。
执行时,一个关键要求是:用环境中的真实反馈判断进展。 这些反馈可以是工具返回的结果,也可以是代码运行后的测试报告。
以修复代码问题为例,Agent 可能先读取相关文件,再修改代码、运行测试;如果测试失败,就根据报错继续定位,而不是因为已经生成了一段代码,就认定任务完成了。
自主性也会增加成本,并可能让错误逐步累积。因此,要提前约定何时需要人介入、何时必须停止,并在沙箱环境中充分测试。
🔧 工具设计:让模型更容易用对
选好架构后,还有一件事值得认真做:让工具清楚、好用、不容易用错。 工具名称和参数要明确,说明里要有示例,再用真实任务检查模型会在哪里出错。
Anthropic 分享过一个例子:Agent 切换工作目录后,使用相对路径容易出错。他们把工具改为要求绝对路径,就解决了这类问题。在构建这个 Agent 时,他们花在工具优化上的时间,甚至比优化整体提示词还多。
💡 写在最后:能简单,就保持简单
读完这些架构,最值得记住的原则其实很朴素:能用简单方案解决的问题,就让它保持简单。
一次模型调用就能做好,就先把这次调用打磨好;固定工作流已经足够稳定,就不必急着让模型自主规划。只有当现有方案确实遇到瓶颈时,再考虑增加新的能力。
每多一步调用、一个分支或一轮循环,都可能增加成本,带来新的故障点。保持简单,有助于定位问题,也更容易验证改动是否有效。
这五种工作流和自主 Agent,都可以按需选择和组合。真正值得追问的是:增加的这份复杂度,究竟解决了什么问题?带来的收益,是否值得?
想清楚这一点,再决定下一步需要增加什么能力。