如何教 AI 做好一张图?我拆了一个 Skill,找到了 4 个关键
从选图、用色到检查成图,看看 dataviz 技能怎样把人的制图经验,变成 AI 可以执行的具体方法。
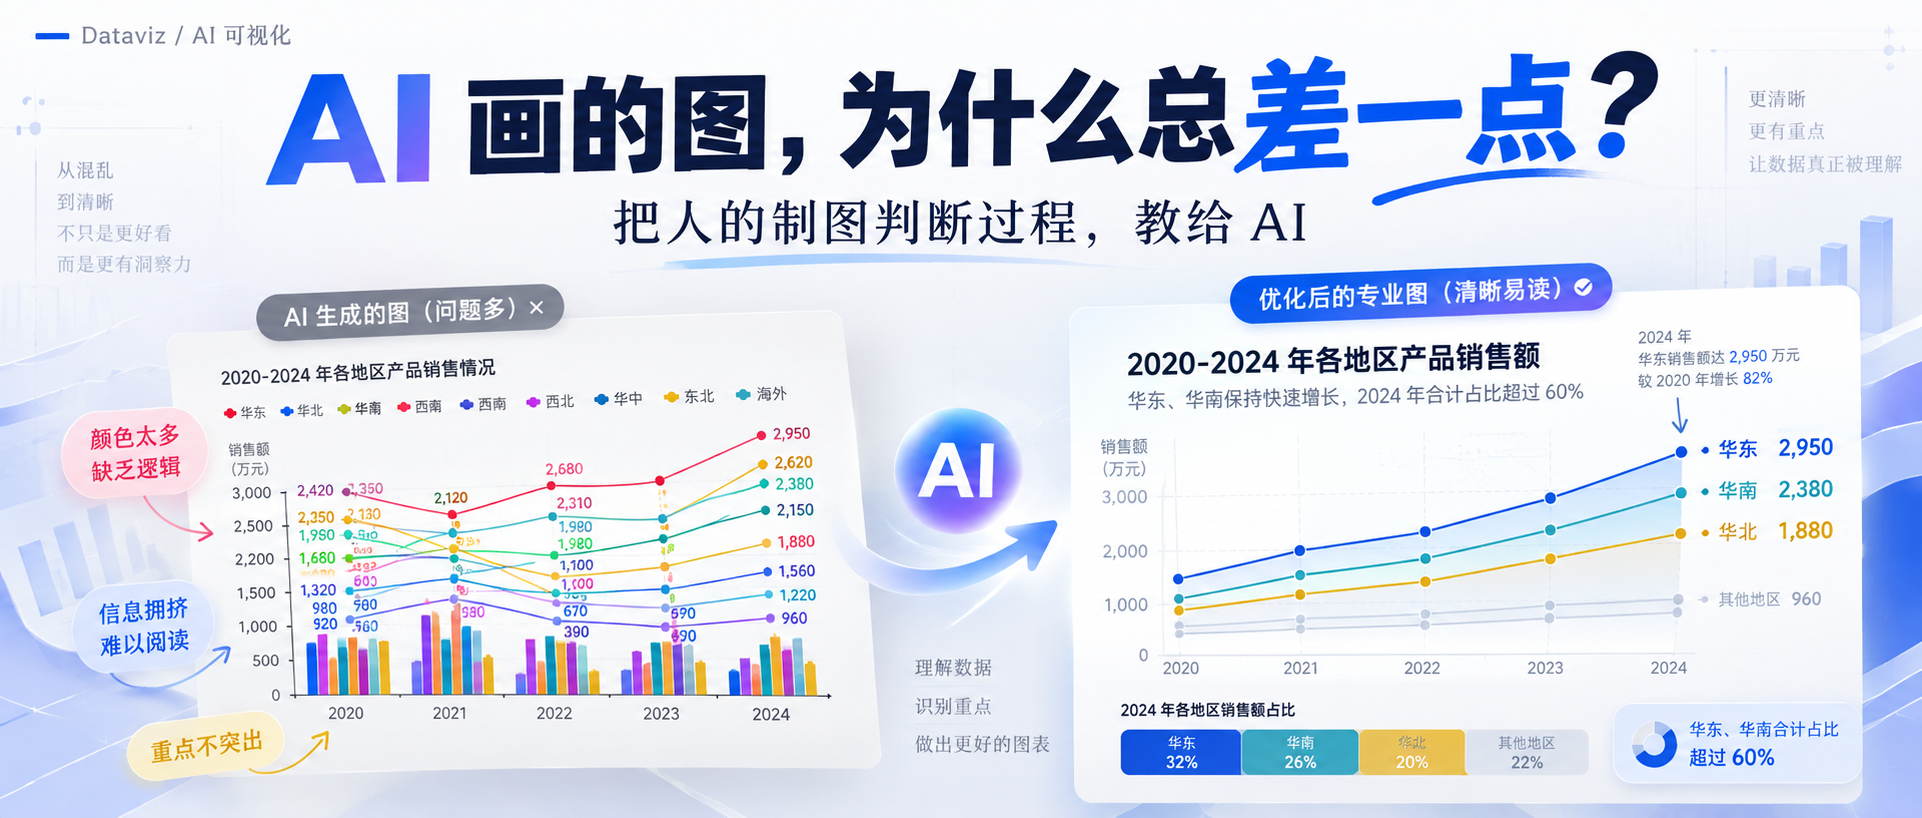
AI 画的图,常常有一种奇怪的感觉。
每个元素似乎都没有错:标题有了,图例有了,数据也准确。可它们放在一起,就是不像一张真正完成的图。
颜色很多,却看不出重点;每个数据点都标了数字,反而什么也读不清;同一个地区在不同图里换了颜色,读者每次都得重新认一遍。
我们通常把这种差距归结为两个字:审美。
仿佛审美只能意会,无法说明,更无法教给 AI。
直到我拆开一个名为 dataviz 的技能,才发现它尝试解决的并不是“如何配出一组漂亮颜色”,而是一个更根本的问题:
如果 AI 已经会画图,我们能不能把人制作一张好图时的判断过程,也教给它?
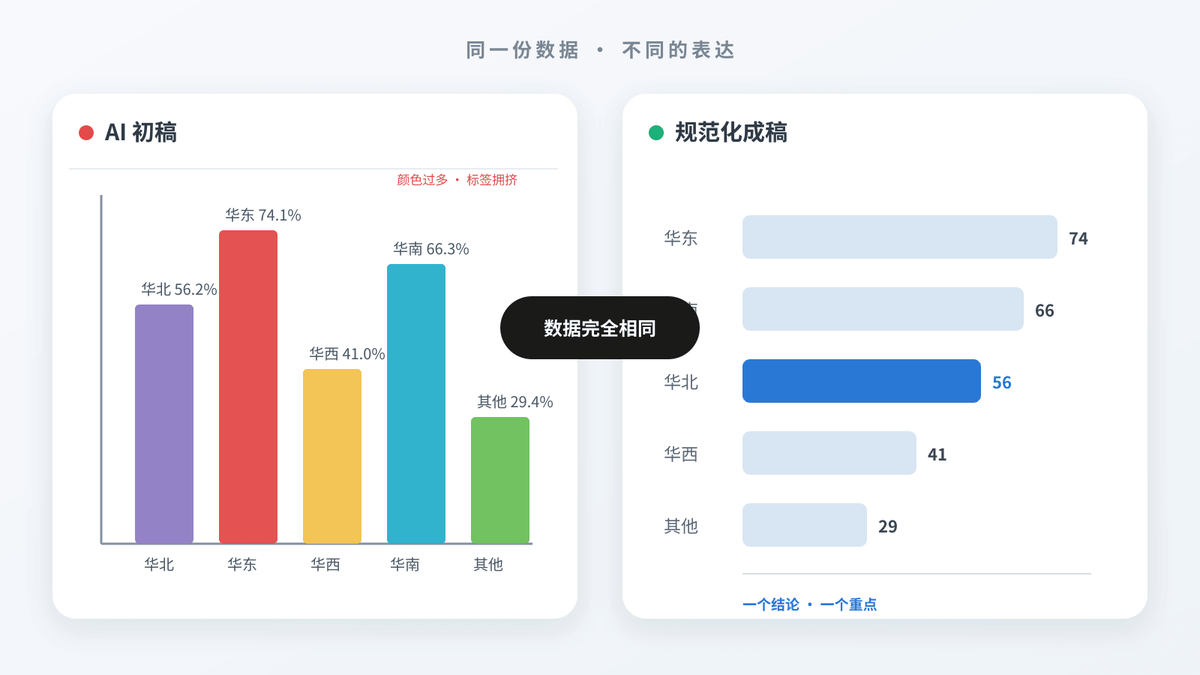
同一份数据的“AI 初稿”和“规范化成稿”对比:左侧颜色杂乱、标签拥挤;右侧重点清楚、留白充足。
它不是绘图软件,而是“制图教练”
你可以把这个技能理解成一份交给 AI 的制图工作指南。
我们平时可能只会说:“帮我把这些数据画成图,好看一点。”它则把“好看一点”展开成了具体要求:先弄清楚要表达什么,再选图、用色,画完以后还要检查。
如果 AI 是制图员,dataviz 就像旁边的教练,提醒它每一步应该考虑什么。
其中最让我有收获的,可以归纳成四个问题。即使不用这个技能,下次让 AI 做图时,也值得问一遍。
我们就拿一个常见场景来说:手上有华东、华南、华北、华西四个地区过去 12 个月的销售数据,想让 AI 帮忙做张图。
01|你想让读者看见什么?
如果只说“帮我画张图”,AI 拿到数据后,可能就直接动手了。
dataviz 要求它先停下来,问一个问题:读者想从数据里看见什么?
如果读者想观察一年中的变化,折线图更合适;如果只想比较本月四个地区的高低,条形图更直接;如果只关心全国总销售额,也许根本不需要图,只需要一个醒目的数字。
这一步看似简单,却拦住了大量“为了画图而画图”的结果。
所以,比起“把销售数据做成图”,更有用的一句话是:“我想让读者一眼看出,这个月哪个地区卖得最多。”
问题说清楚了,AI 才有依据决定该保留什么、突出什么。
图表类型不是由数据字段机械决定的,而是由分析问题决定的。
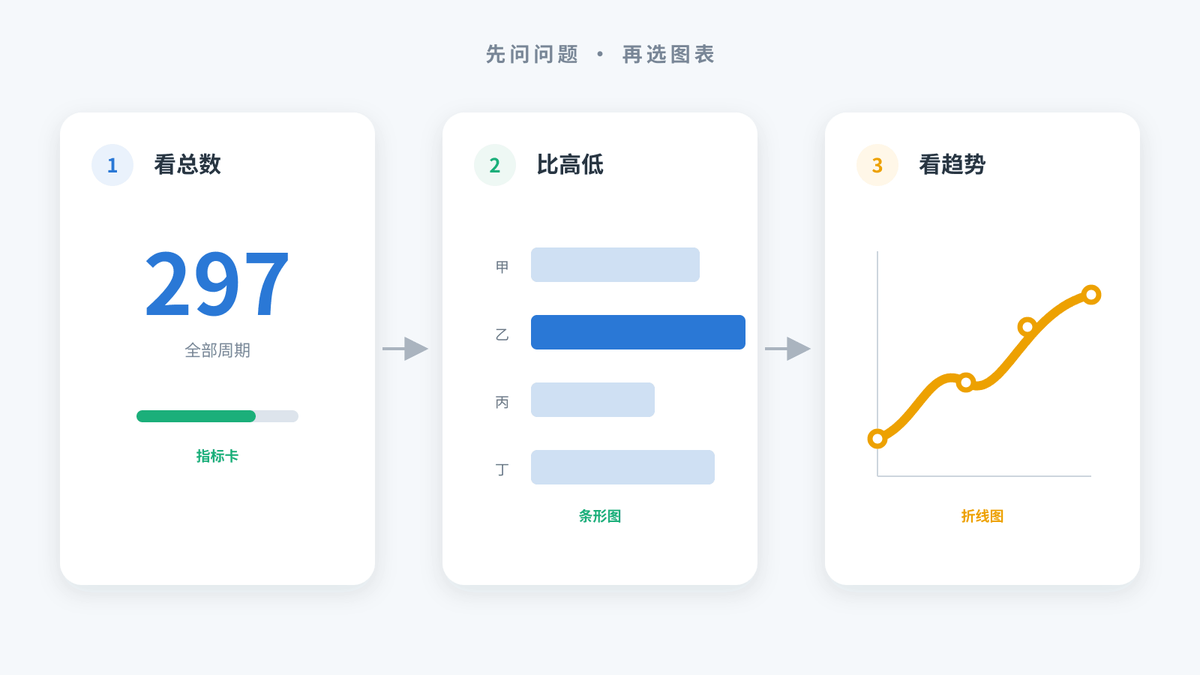
同一份数据对应三种问题——“看总数”“比高低”“看趋势”,分别对应指标卡、条形图和折线图。
02|颜色是在传递信息,还是只是热闹?
在四地区销售图中,颜色的任务是区分地区。
例如:华东固定为蓝色,华南固定为青绿色,华北固定为黄色,华西固定为紫色。
一旦确定,在同一份报告的其他图表里也应该保持一致。即使某张图只展示两个地区,华东仍然应该是蓝色。
否则,读者刚记住“蓝色代表华东”,下一张图里蓝色却变成了华西。
这就是技能里很重要的一条规则:
颜色跟随实体,不跟随排名。
但如果我们要表达的是销售额从低到高,用同一种颜色由浅到深,通常比摆出一排彩虹色更容易理解。
颜色要跟着表达目的走。动手配色前,先问一句:这里需要读者区分地区,还是看出数值大小?
还有一个容易忽略的问题:你觉得分得清,不代表别人也分得清。
两种看起来差别很大的颜色,对部分色觉障碍读者来说,可能很接近;浅色的线放在白底上,也可能很难看清。
所以,dataviz 附带了配色检查工具,让 AI 实际检查颜色能否区分、与背景的对比是否足够。
发现问题后,还可以给线条直接写上地区名称,或用不同形状的数据点辅助区分。这样读者不必只靠认颜色来理解图表。
能计算的质量问题,就不让 AI 凭感觉回答。
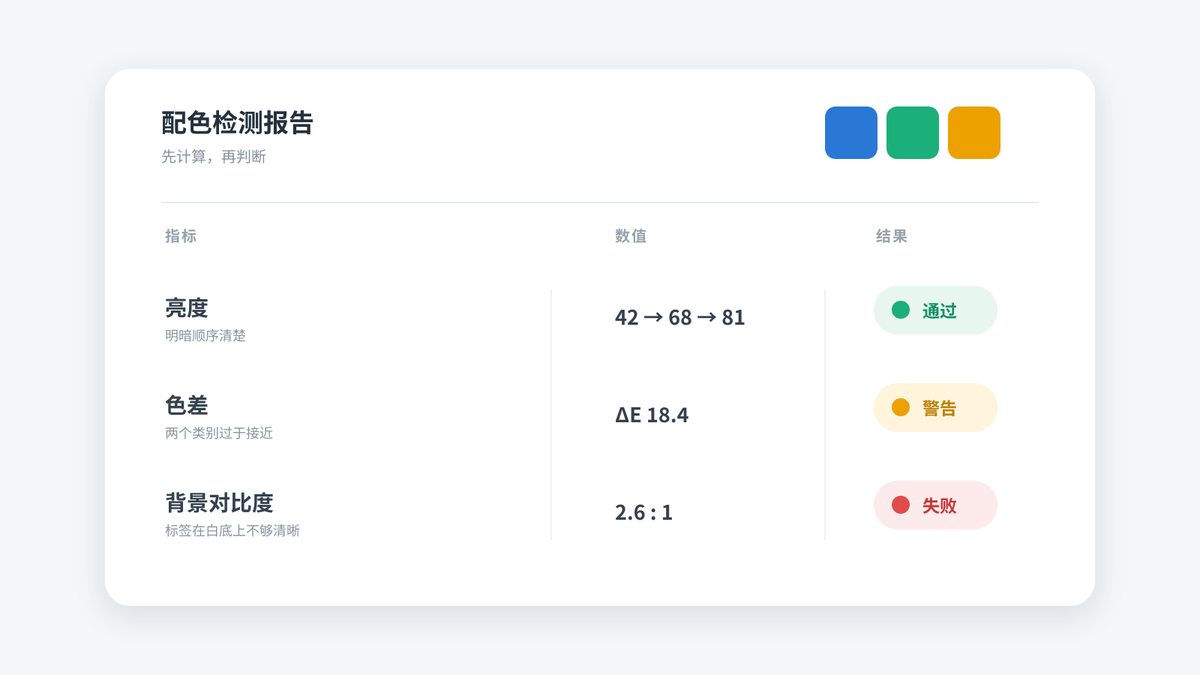
配色也可以做检查:哪些颜色容易混淆,哪些放在背景上不够清楚,都值得在交付前确认。
03|所谓“好看”,能不能说得具体一点?
图表选对、颜色通过,不代表作品已经完成。
线太粗、点太小、网格线太重,仍然会让数据难以阅读。
我们常给 AI 的修改意见是:“再高级一点”“再简洁一点”。但这些话很难让它知道,究竟应该改哪里。
这个技能把要求写得很具体。换成日常语言,大致就是:
- 网格线淡一点,别抢走数据的注意力;
- 线条和数据点要清楚,但不必一味加粗、放大;
- 不要给每个数据点都贴数字,只标真正重要的位置;
- 标签放不下就调整位置,别把文字挤在一起或裁掉;
- 图里有多个地区,就让读者能找到各自对应哪条线。
拿四个地区的销售趋势来说,12 个月一共有 48 个数据点。如果全部标上数字,读者很可能先看到一团文字,反而看不清走势。
如果这张图想说明“华东在下半年增长明显”,就可以重点标出转折处和年末数值。其余数字是否需要展示,要看它们对理解这个结论有没有帮助。
这些规则不会决定图表必须长成同一种样子,却建立了一条清晰的质量底线:
数据可以醒目,网格线、坐标轴和容器应该后退。
04|AI 画完以后,有没有真的检查过?
配色检查通过了,也不代表最终的图就没有问题。文字可能重叠,标题可能被截断,图例也可能挤成一团。
所以,技能的最后一步不是“保存文件”,而是要求 AI 打开页面或查看截图。
这一步很像我们做完 PPT 后,把它全屏放一遍。编辑时觉得没问题的地方,真正展示出来,往往就能看出不对劲。
回到那张销售图:地区名称有没有挤在一起?月份有没有显示完整?想强调的增长趋势,第一眼能不能看出来?
尤其是放进公众号的图,还值得在手机上看一遍。电脑上清楚的字,缩到手机屏幕里,可能已经读不出来了。
发现问题就修改,然后再看一次实际效果。
这不是“生成一次就结束”,而是“生成—检查—修改—复查”。
从一张图表,再往前走一步
审美当然有主观部分。
有人喜欢克制,有人喜欢活泼;品牌选择冷色还是暖色,也不存在唯一答案。
但“是否误导、是否清楚、是否一致、是否能被不同用户读取”,并不完全是主观感受。
dataviz 让我看到,很多原本藏在经验里的判断,其实可以拆开说明:先明确问题,再安排颜色和视觉重点,最后检查实际效果。
下次让 AI 做图时,我们也可以把“帮我做得好看一点”,换成更具体的要求:
我想比较本月四个地区的销售额,让读者一眼看出谁最高。请选合适的图表,减少不必要的装饰,让重点清楚。完成后查看成图,检查文字是否重叠、标签是否完整、颜色是否容易区分。
这段话当然不能代替完整的技能,但它让 AI 知道了我们要什么,也给出了检查结果的依据。
这个技能真正做的,是把人的制图经验,整理成 AI 可以执行、也可以自我检查的工作方法。
这或许也是 AI 技能最值得期待的形态。
不是只告诉 AI“做什么”,而是进一步教会它:
怎样做,以及怎样知道自己真的做好了。